Was tokentoll macht
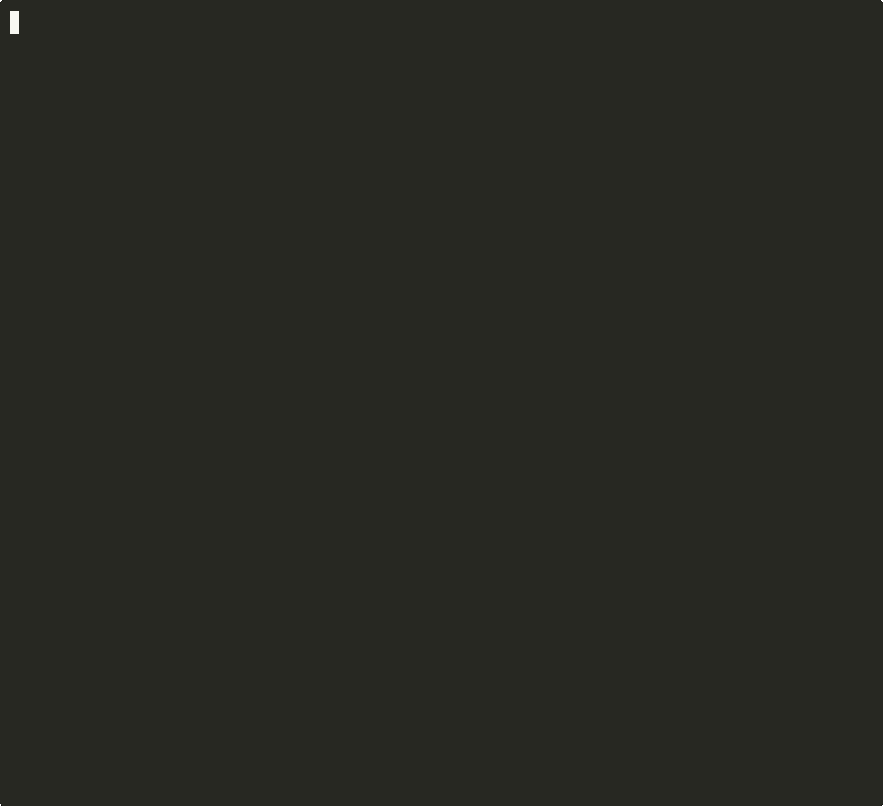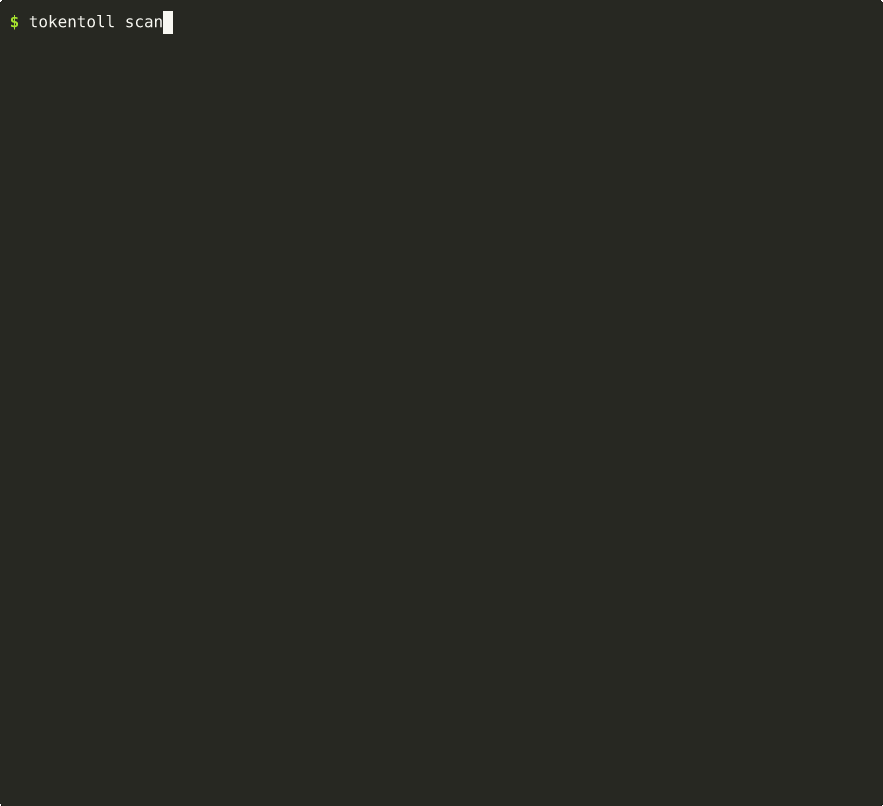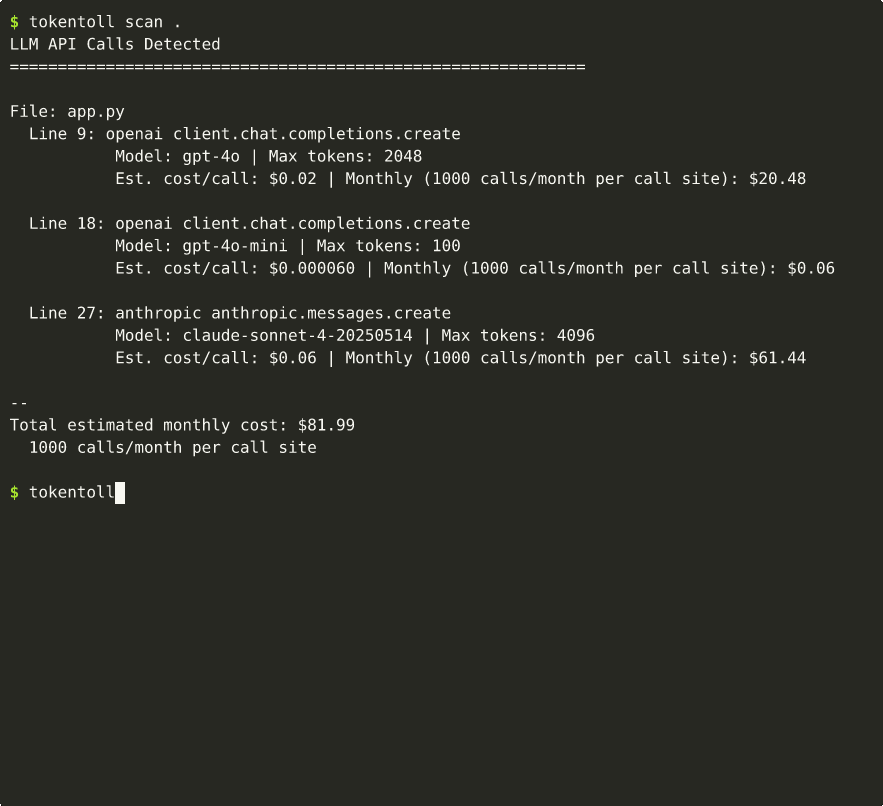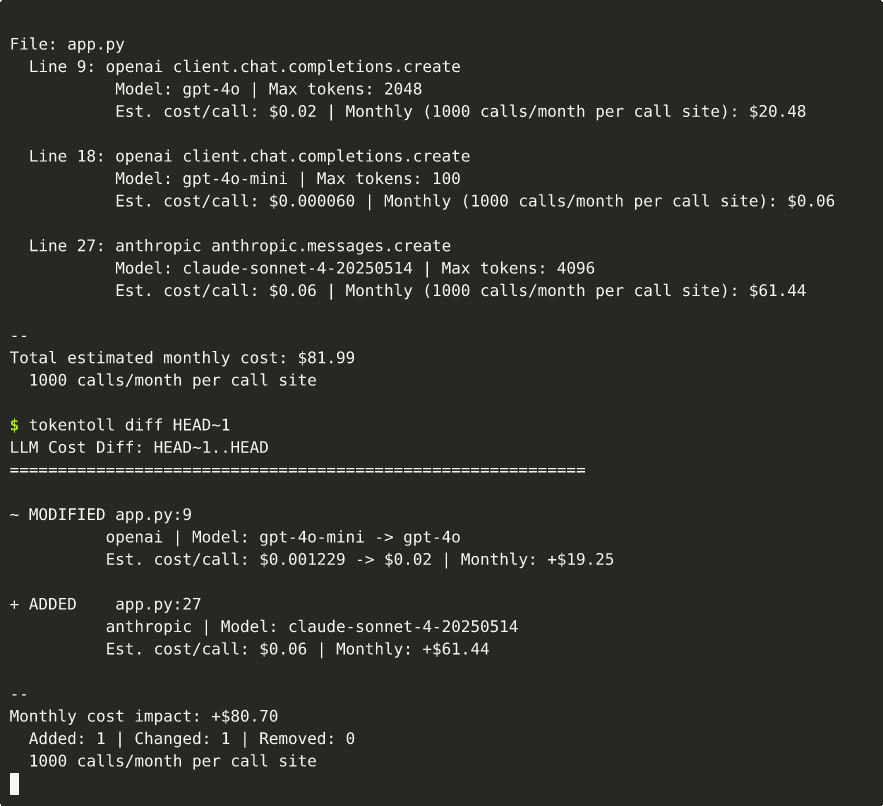
tokentoll findet LLM-API-Aufrufe im
Quellcode, schätzt ihre monatlichen Kosten und zeigt, wie ein Git-Diff diese
Schätzung verändert. Infracost macht dasselbe für Terraform und
Cloud-Ressourcen. Codeänderungen, die LLM-Kosten beeinflussen, sind zum
Beispiel ein anderes Modell, eine neue Aufrufstelle oder ein entfernter
max_tokens-Parameter.
Dieser Beitrag beschreibt die erste Version vom Mai 2026, die nur Python gescannt hat. Der letzte Abschnitt nennt, was sich seitdem geändert hat.
Architektur
tokentoll besteht aus fünf Komponenten:
- Scanner: durchläuft Python-Dateien und übergibt jede Datei an die Detektoren.
- Detektoren: einer pro SDK (OpenAI, Anthropic, Google, LiteLLM, LangChain). Jeder findet die API-Aufrufe seines SDKs im Python-AST.
- Pricing-Engine: ordnet einem Modellnamen Kosten pro Token zu, mit gestaffelter Namensauflösung, SDK-spezifischen Default-Modellen für dynamische Modellnamen und einem lokalen Cache.
- Diff-Engine: ordnet alte und neue Aufrufe über Datei und Zeilennähe einander zu.
- Output-Formatter: Tabelle (CLI), Markdown (PR-Kommentar), JSON.
Designentscheidungen:
- Die erste Version hatte keine Laufzeitabhängigkeiten. Sie nutzte nur die
Standardbibliothek:
astzum Parsen,jsonfür Daten,subprocessfür Git,argparsefür die CLI undurllibfür den Abruf der Preise. - Jeder Detektor ist eine Datei, die
can_handle()unddetect()implementiert. Ein neues SDK erfordert keine Änderung am Scanner oder an der Pipeline. - Die Preise stammen aus der Pricing-Datenbank von LiteLLM (2.200+ Modelle) und
werden in
~/.tokentoll/zwischengespeichert. tokentoll warnt bei einem veralteten Cache und bricht bei einem sehr alten Cache mit einem Fehler ab. - Ist ein Modellname dynamisch, wird er also zum Beispiel zur Laufzeit aus einer Config oder einer Umgebungsvariable gelesen, bepreist tokentoll den Aufruf mit einem Default-Modell des SDKs: gpt-4o für OpenAI, claude-sonnet für Anthropic, gemini-flash für Google. Auch Aufrufe mit dynamischen Modellnamen bekommen so eine Kostenschätzung.
Auflösung von Modellnamen zu Preiseinträgen
Im Code steht model="gpt-4o", die Pricing-Datenbank enthält Einträge wie
gpt-4o, openai/gpt-4o, gpt-4o-2024-08-06 und azure/gpt-4o. tokentoll
probiert diese Schritte der Reihe nach:
- Exakte Übereinstimmung
- Übereinstimmung ohne Beachtung der Groß- und Kleinschreibung
- SDK-Präfix anhängen und abgleichen (
openai/gpt-4o) - Provider-Präfix aus den Datenbank-Keys entfernen und abgleichen
- Regionspräfix entfernen (
us.,eu.,apac.) - Datumssuffix entfernen (
-2024-08-06,-20240806)
In den Open-Source-Projekten, die ich gescannt habe, hat das die meisten Modellnamen aufgelöst.
Mehrstufige Konstantenpropagation
Modellnamen stehen an der Aufrufstelle selten als String-Literal. Sie laufen
durch Variablen, Klassenattribute, Config-Objekte und **kwargs:
DEFAULT_MODEL = os.getenv("MODEL", "gpt-4o")

class Config:
    model: str = DEFAULT_MODEL

config = Config()
kwargs = {"model": config.model, "max_tokens": 2000}
client.chat.completions.create(**kwargs)
# tokentoll löst auf: model="gpt-4o", max_tokens=2000
Die Engine wiederholt ihre Durchläufe, bis sich kein aufgelöster Wert mehr
ändert. Sie folgt Variablenzuweisungen, os.getenv()-Fallbacks,
Funktions-Defaults, Defaults von Klassenattributen, Konstruktorargumenten,
Dict-Inhalten und **kwargs-Unpacking.
Konfiguration
Eine .tokentoll.yml-Datei legt die Annahmen pro Projekt fest:
calls_per_month: 5000
default_models:
  openai: gpt-4o-mini
  anthropic: claude-haiku-3-20240307
overrides:
  - path: tests/
    calls_per_month: 100
Pfad-Overrides nutzen Longest-Prefix-Matching. So können Testcode, Agent-Pipelines und Batchjobs unterschiedliche Aufrufvolumen und Default-Modelle haben.
Test an zwanzig Open-Source-Codebases
Ich habe tokentoll auf zwanzig Open-Source-Codebases laufen lassen, darunter NadirClaw, PraisonAI, agentops, swarms, honcho und atomic-agents. Es hat in allen OpenAI-, Anthropic-, Google- und LiteLLM-Aufrufe erkannt. In Projekten, die Modellnamen zur Laufzeit aus der Config laden, haben die SDK-spezifischen Default-Modelle trotzdem Kostenschätzungen geliefert.
Änderungen seit der ersten Version
Spätere Versionen scannen auch JavaScript und TypeScript (geparst mit
tree-sitter, das jetzt eine Laufzeitabhängigkeit ist) und erkennen weitere
SDKs wie das Vercel AI SDK. Eine Policy in .tokentoll.yml ergänzt den
PR-Kommentar um ein Urteil PASS, WARN oder FAIL und kann den Workflow
fehlschlagen lassen. tokentoll läuft außerdem als MCP-Server. Die Preisdaten
werden mit dem Paket ausgeliefert und lassen sich mit tokentoll update aus
LiteLLM aktualisieren.
Nutzung
pip install tokentoll
tokentoll scan .
tokentoll diff HEAD~1
GitHub: github.com/Jwrede/tokentoll