llmprobe ist ein Open-Source-Go-CLI, das ich geschrieben habe. Es schickt Streaming-Anfragen an LLM-Endpoints und misst Time to First Token (TTFT), Gesamtlatenz und Generierungsdurchsatz. Es verwendet einfaches HTTP und einen eigenen SSE-Parser statt der SDKs der Anbieter.
Ich habe es sieben Tage lang gegen sechs Modelle über OpenRouter laufen lassen.
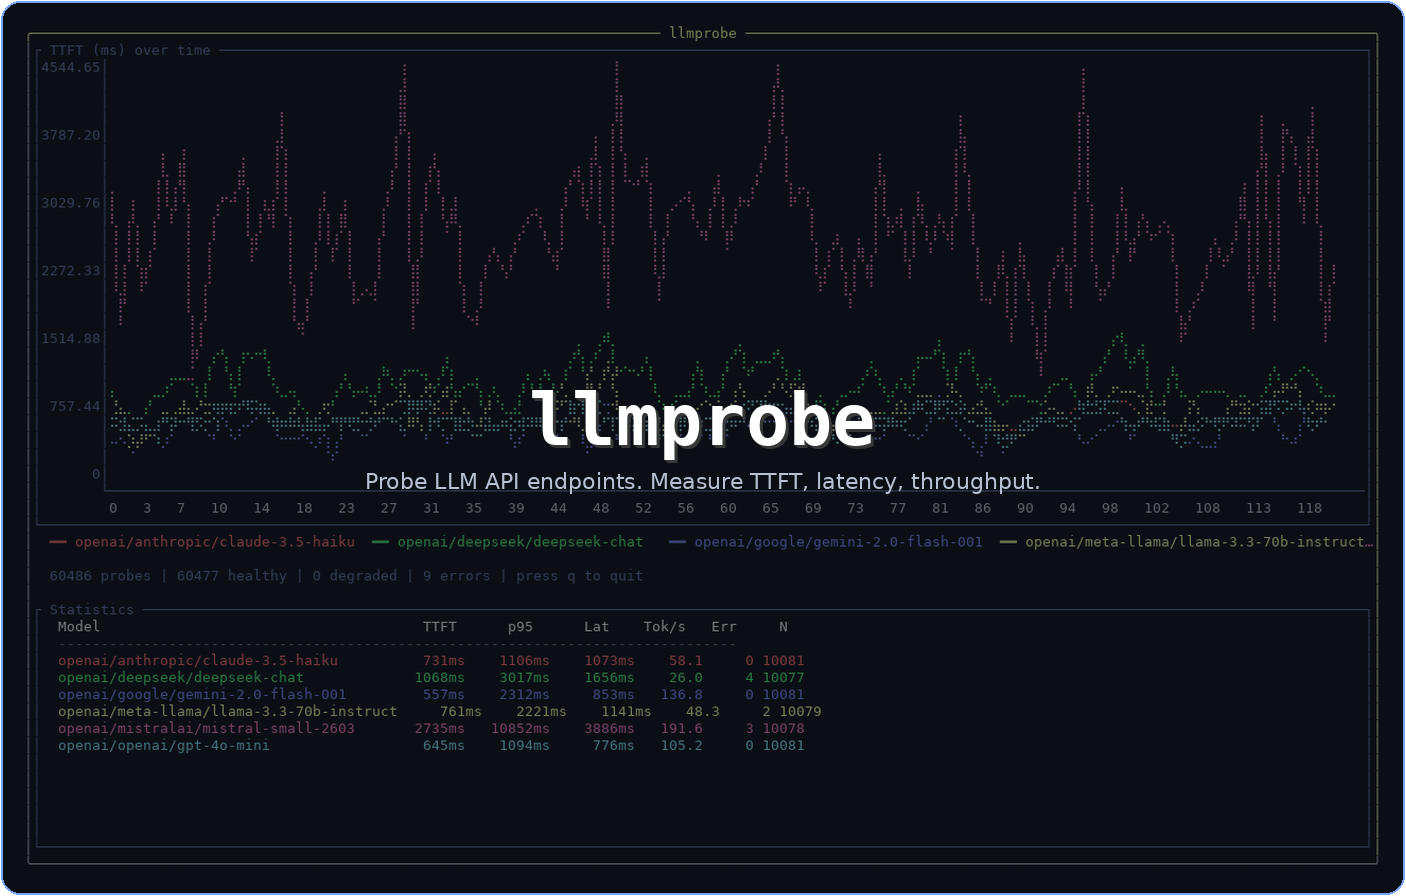
Setup
Alle 60 Sekunden hat llmprobe den Prompt "Hello" mit einem Limit von 20 Ausgabe-Tokens an jedes Modell geschickt. Der kurze Prompt und das Ausgabelimit halten die Generierungszeit klein, sodass die Zahlen vor allem beschreiben, wie lange es bis zum Beginn der Antwort dauert.
Modelle: GPT-4o-mini, Claude 3.5 Haiku, Gemini 2.0 Flash, Llama 3.3 70B, DeepSeek Chat, Mistral Small.
Probes insgesamt: 60.480 (etwa 10.080 pro Modell).
Alle Anfragen liefen über OpenRouter. Die Zahlen enthalten daher den Proxy-Overhead von OpenRouter und beschreiben diesen Weg in dieser Woche. Sie sind keine Messungen der nativen APIs der Anbieter.
Ergebnisse
| Modell | TTFT p50 | TTFT p95 | Latenz | Tok/s | Fehler |
|---|---|---|---|---|---|
| GPT-4o-mini | 645ms | 1.094ms | 776ms | 105,3 | 0 |
| Claude 3.5 Haiku | 731ms | 1.106ms | 1.073ms | 58,1 | 0 |
| Gemini 2.0 Flash | 556ms | 2.313ms | 853ms | 136,8 | 0 |
| Llama 3.3 70B | 761ms | 2.221ms | 1.141ms | 48,3 | 2 |
| DeepSeek Chat | 1.068ms | 3.017ms | 1.656ms | 26,0 | 4 |
| Mistral Small | 2.735ms | 10.852ms | 3.886ms | 191,6 | 3 |
Median und p95 der TTFT
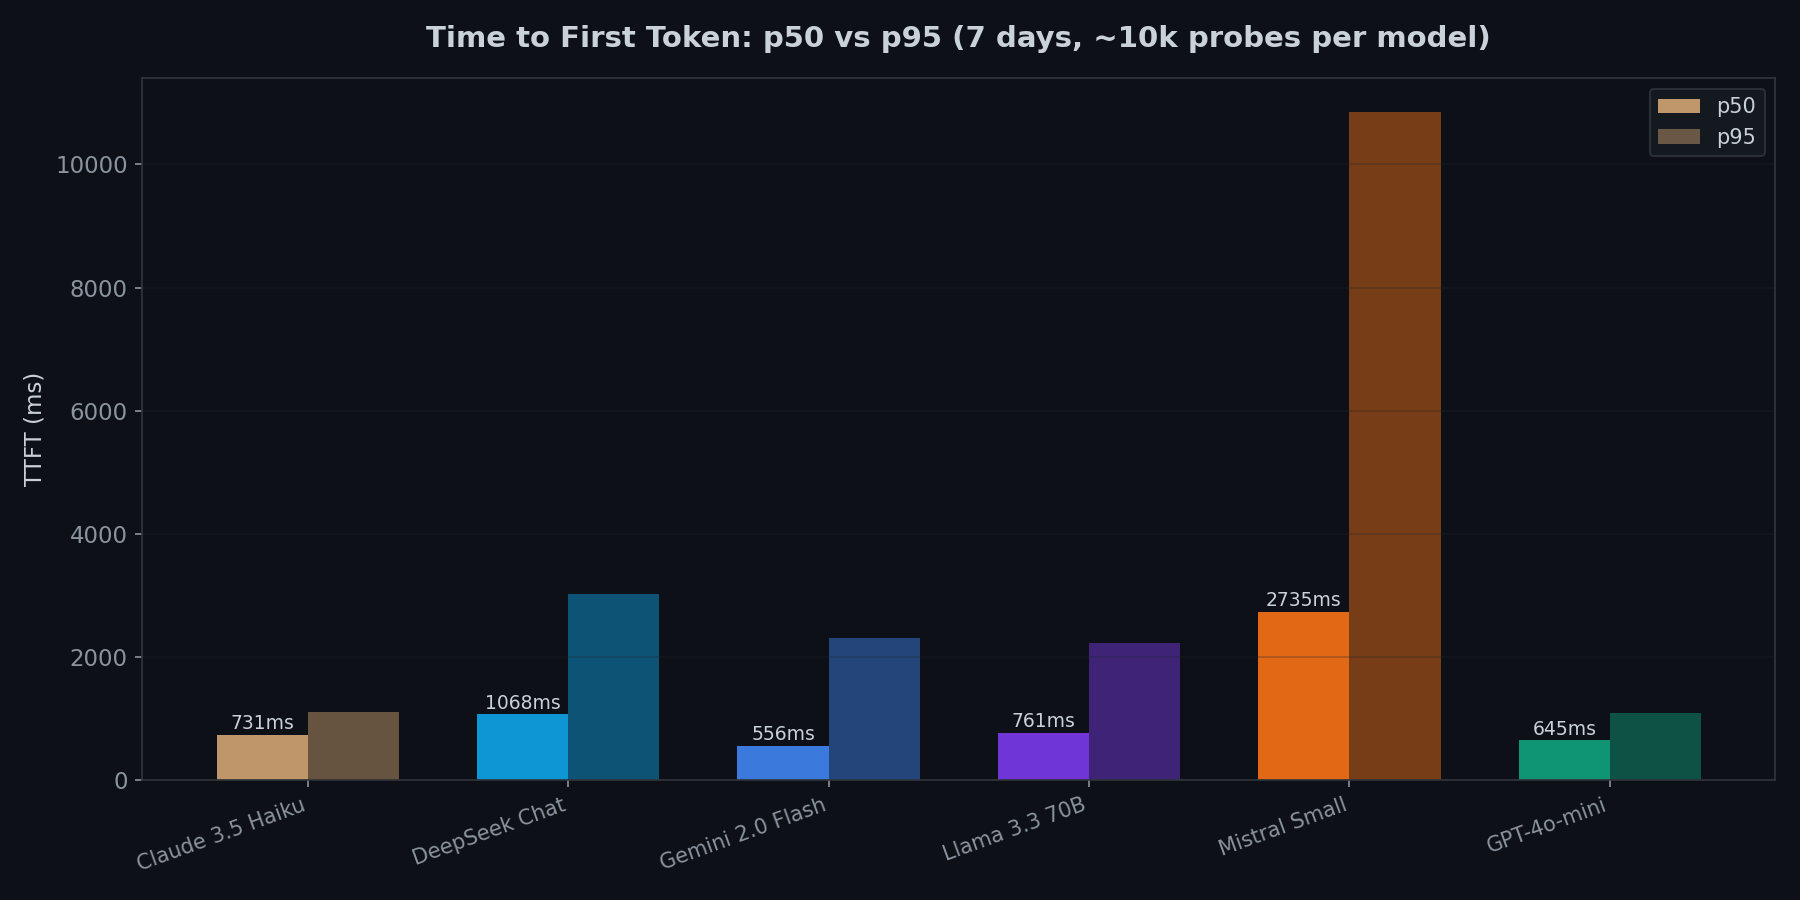
Gemini 2.0 Flash hatte den niedrigsten Median-TTFT (556ms). Der p95 lag bei 2.313ms, etwa beim 4-Fachen des Medians. Bei GPT-4o-mini und Claude 3.5 Haiku lag der p95 unter dem 1,7-Fachen des Medians.
Mistral Small hatte einen Median-TTFT von 2.735ms und einen p95 von 10.852ms. Etwa 5% der Anfragen brauchten also mehr als 10 Sekunden bis zum ersten Token. Der stündliche Median lag fast die ganze Woche über dem der anderen Modelle (siehe Zeitverlauf unten).
TTFT und Generierungsdurchsatz
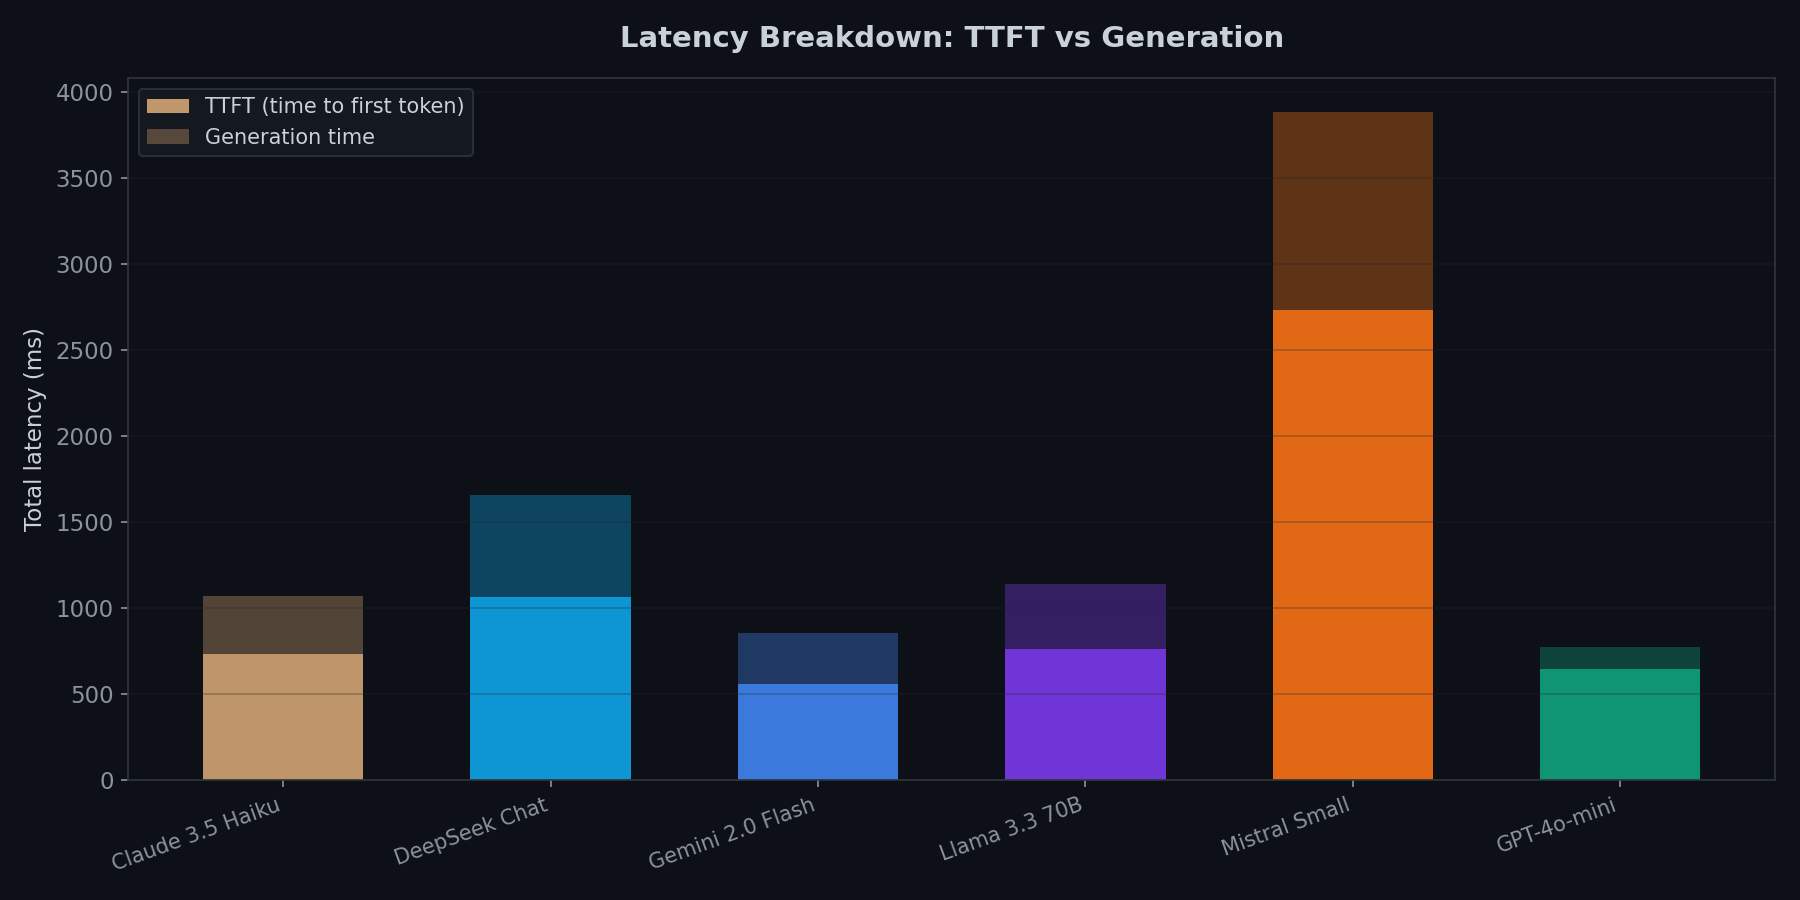
Mistral Small hatte den höchsten TTFT und zugleich den höchsten gemessenen Durchsatz, 191,6 Tok/s. Gemini 2.0 Flash folgte mit 136,8 Tok/s. DeepSeek Chat hatte einen hohen TTFT (1.068ms) und den niedrigsten Durchsatz (26,0 Tok/s).
Der Durchsatz wird aus den Tokens nach dem ersten Token und der Zeit zwischen erstem Token und Ende des Streams berechnet. Bei einem Ausgabelimit von 20 Tokens ist dieses Intervall kurz, die Durchsatzwerte sind daher nur ein grobes Maß.
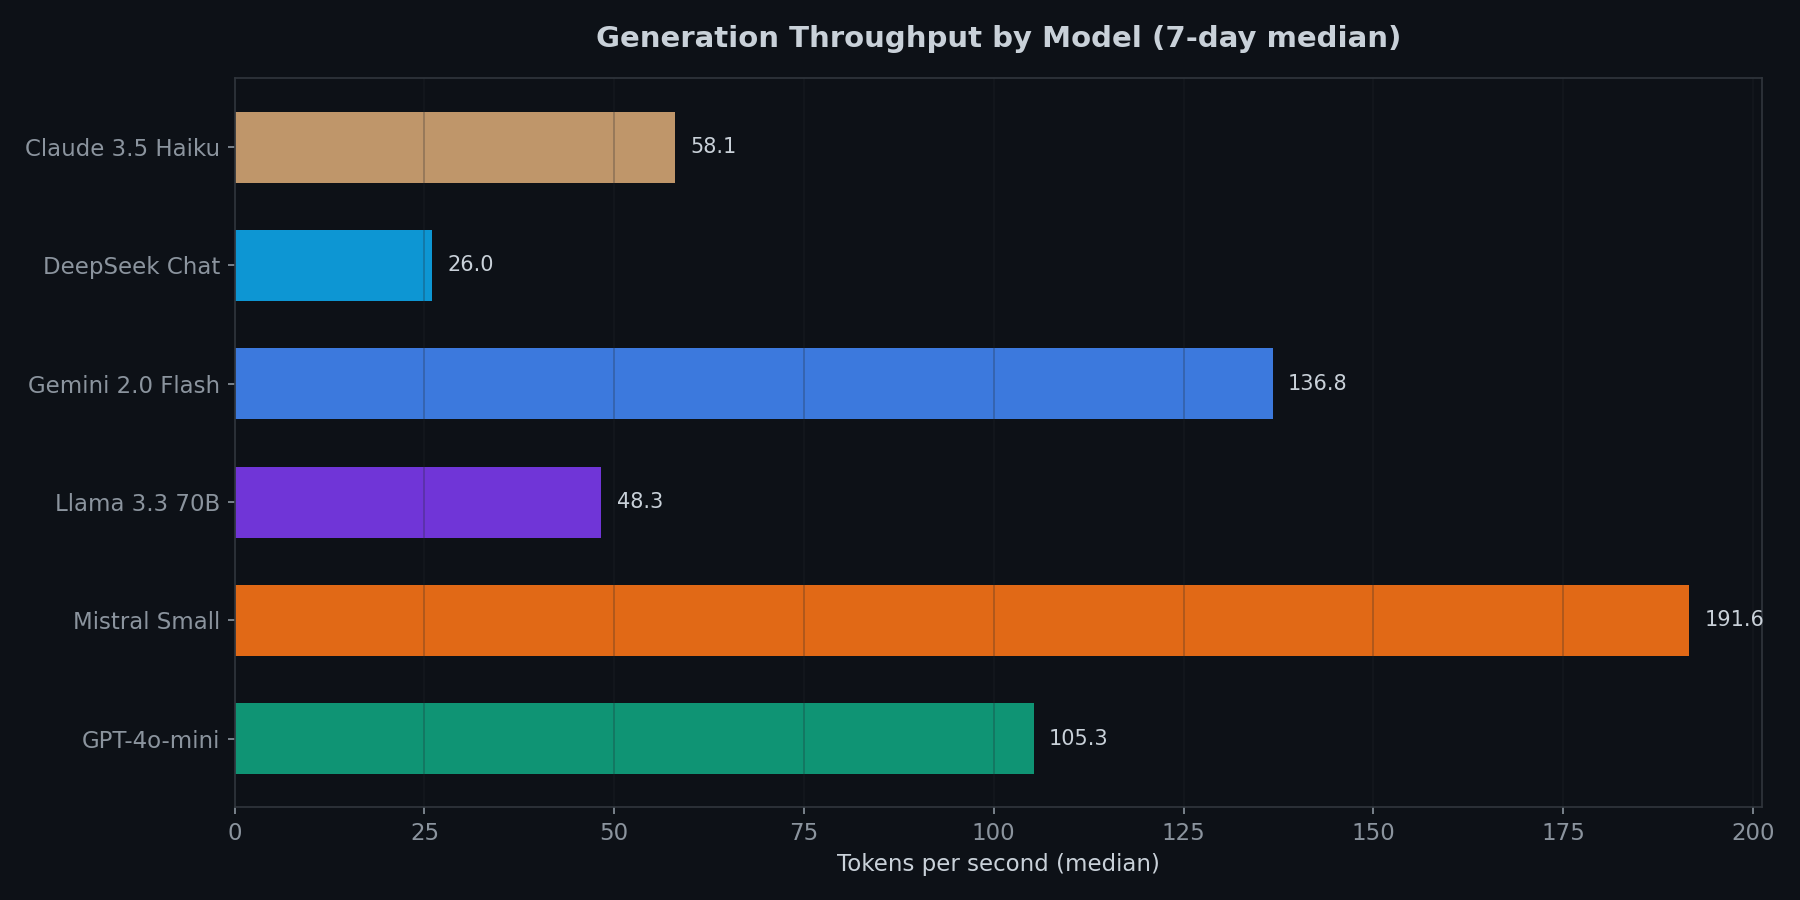
Verteilung der TTFT
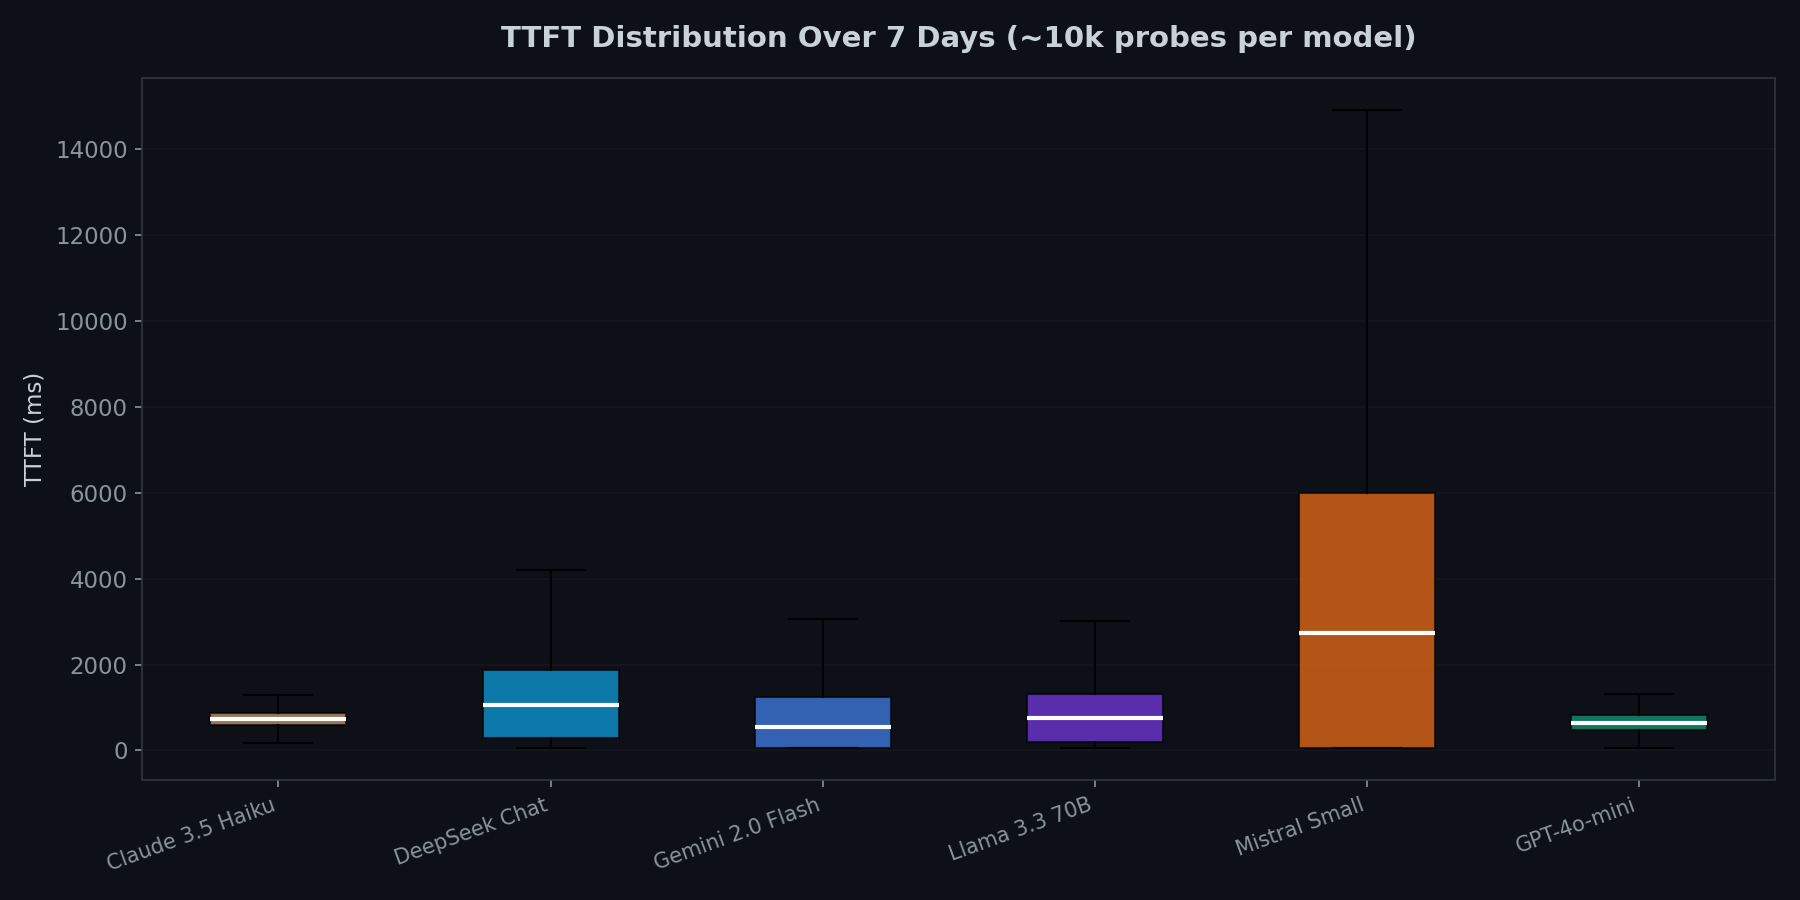
GPT-4o-mini und Claude 3.5 Haiku hatten die engsten TTFT-Verteilungen. Bei beiden lag der p95 unter 2 Sekunden, ein TTFT-Timeout von 2 Sekunden wäre also von weniger als 5% der Anfragen überschritten worden. Gemini 2.0 Flash und Llama 3.3 70B hatten längere Tails. Mistral Small hatte die breiteste Verteilung.
TTFT über die sieben Tage
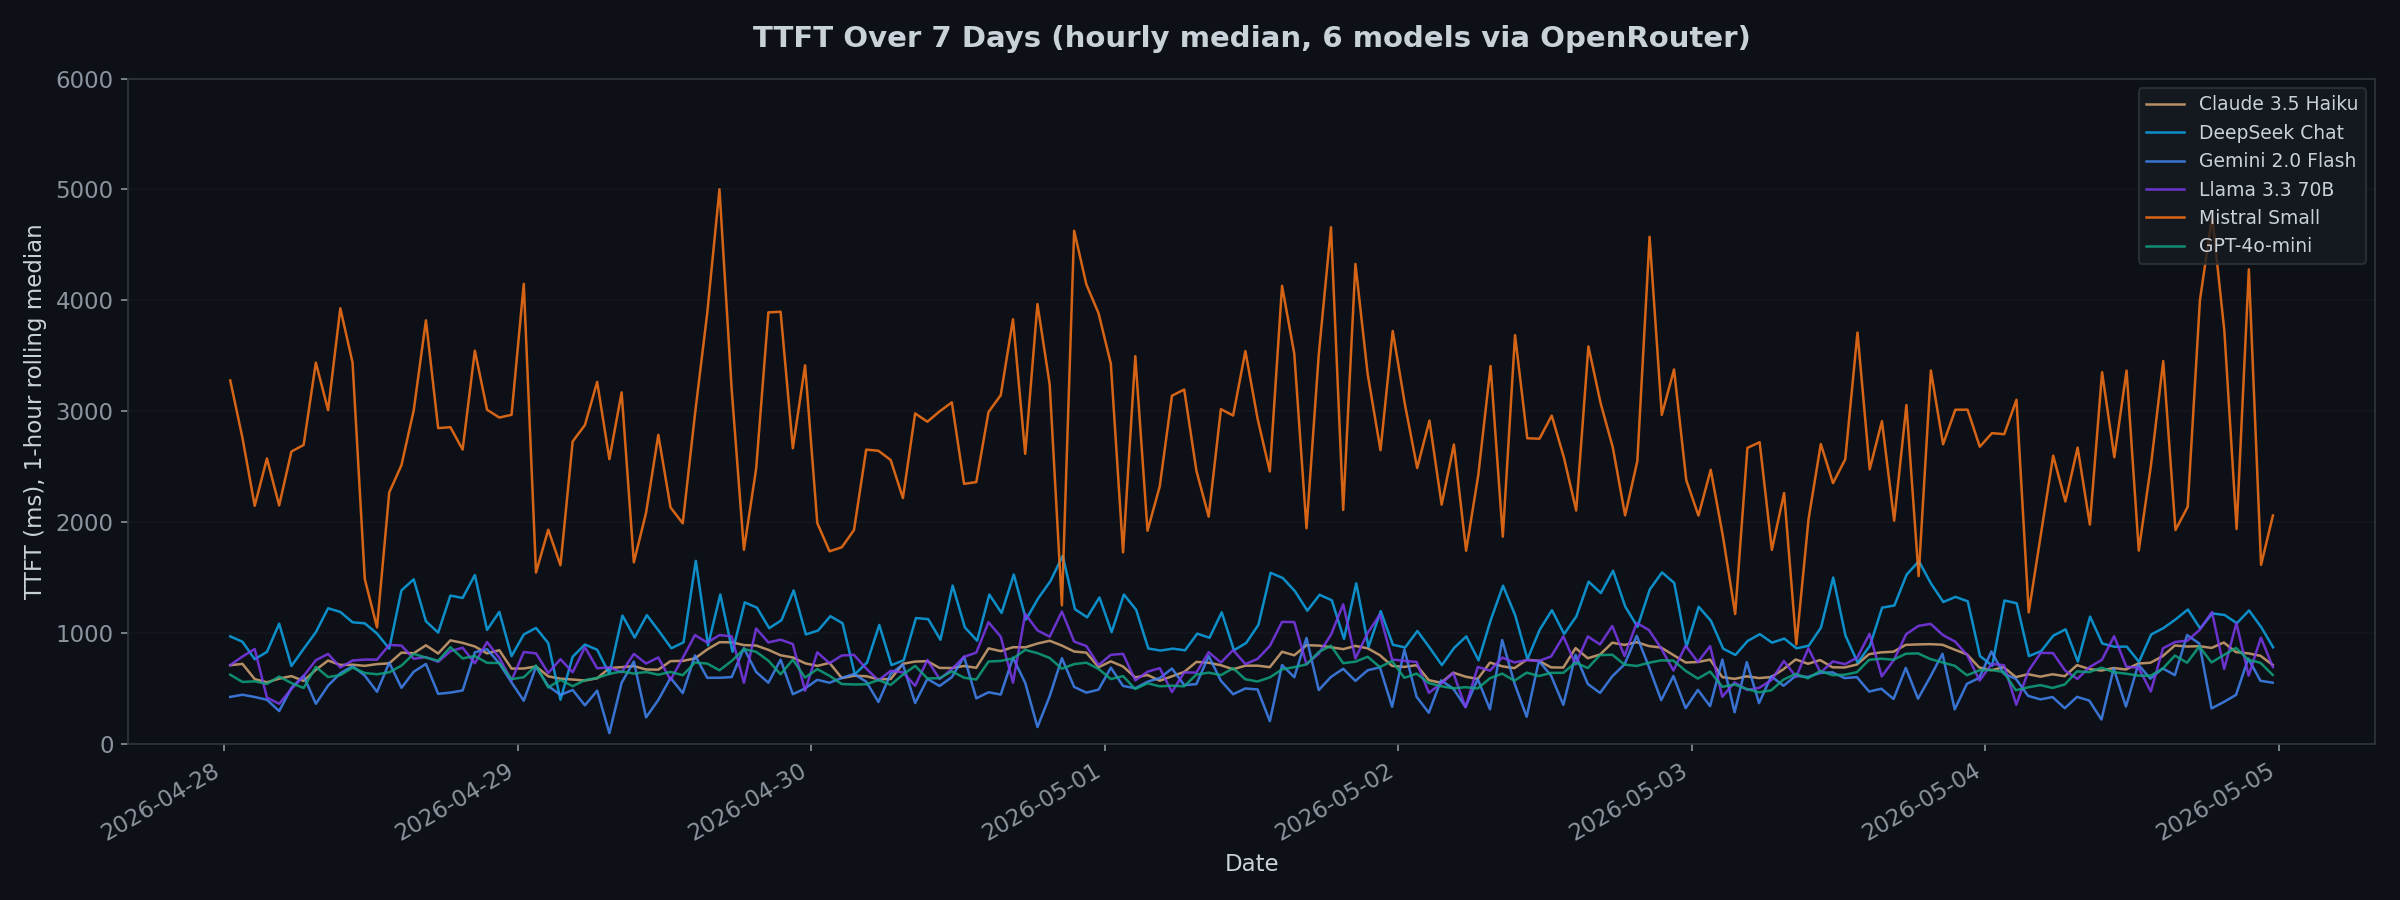
Der Zeitverlauf zeigt den stündlichen Median-TTFT pro Modell.
- Mistral Small schwankte die ganze Woche über stark, mit Spitzen nahe 5.000ms.
- DeepSeek Chat hatte mehrere Zeitfenster mit höherer Latenz. Die Ursache geht aus den Daten nicht hervor.
- GPT-4o-mini und Claude 3.5 Haiku schwankten über die Woche nur wenig.
llmprobe als CI-Prüfung
llmprobe kann in einer Deploy-Pipeline laufen und den Job fehlschlagen lassen, wenn ein Endpoint seine konfigurierten Schwellenwerte nicht einhält.
# .github/workflows/deploy.yml
- name: LLM-Provider prüfen
  env:
    OPENAI_API_KEY: ${{ secrets.OPENAI_API_KEY }}
    ANTHROPIC_API_KEY: ${{ secrets.ANTHROPIC_API_KEY }}
  run: |
    go install github.com/Jwrede/llmprobe@latest
    llmprobe probe --fail-on degraded
Mit --fail-on degraded beendet sich llmprobe mit Exit-Code 1, wenn eine
Anfrage fehlschlägt oder ein Endpoint einen seiner Schwellenwerte
überschreitet, und der Workflow-Schritt schlägt fehl.
Schwellenwerte werden pro Modell in probes.yml gesetzt:
providers:
  - name: openai
    api_key: ${OPENAI_API_KEY}
    models:
      - name: gpt-4o-mini
        thresholds:
          max_ttft: 2s
          max_latency: 5s
          min_tokens_per_sec: 50
Die folgenden Beispiel-Schwellenwerte für TTFT liegen über den p95-Werten dieser Woche. Sie beruhen auf diesem Weg und Zeitraum und sollten mit eigenen Messungen überprüft werden.
| Modell | Beispiel max_ttft | Grundlage |
|---|---|---|
| GPT-4o-mini | 1,5s | p95 1.094ms |
| Claude 3.5 Haiku | 1,5s | p95 1.106ms |
| Gemini 2.0 Flash | 3s | p95 2.313ms |
| Llama 3.3 70B | 3s | p95 2.221ms |
| DeepSeek Chat | 5s | p95 3.017ms |
| Mistral Small | 15s | p95 10.852ms |
Unterstützte Anbieter
llmprobe unterstützt OpenAI, Anthropic, Google, Azure, AWS Bedrock und jeden OpenAI-kompatiblen Endpoint (Groq, Together, Fireworks, DeepSeek, Mistral, OpenRouter, Ollama, vLLM). Jeder Provider-Client ist ein kleiner HTTP-Wrapper mit SSE-Parsing. Der Bedrock-Client implementiert SigV4-Signierung und das Parsen des AWS Binary Event Stream ohne SDK.
go install github.com/Jwrede/llmprobe@latest
llmprobe watch --tui --interval 60s
GitHub: github.com/Jwrede/llmprobe
Nachtrag: stündlicher Benchmark
Nach diesem Beitrag habe ich einen kontinuierlichen Benchmark auf Basis von llmprobe aufgesetzt. Er misst jede Stunde 15 Modelle von OpenAI, Anthropic, Google, DeepSeek und xAI. Die Modellliste wird täglich anhand der wöchentlichen Popularitäts-Rankings von OpenRouter aktualisiert.
Das Dashboard ist unter bench.jonathanwrede.de erreichbar, die Rohdaten werden als JSONL unter github.com/Jwrede/llm-bench-data veröffentlicht.
Infrastruktur-Code: github.com/Jwrede/llm-bench